转载声明:本文转载自今日头条,作者为 星尘号,原文链接:https://www.toutiao.com/article/7706883287427318281/,原文发表于 2026-11-11。版权归原作者所有,转载仅作分享学习。
11 月 10 号晚上,MiniMax 把 H3-Image 的权重放了出来。33.1B 参数,五十层,稠密架构,官方列出的支持硬件是 H200、RTX PRO 6000 Blackwell 这一档。
我桌上这台是 4070 Ti SUPER,16G 显存。
差了三个档。
我还是装了。装之前先算了一遍体积:bf16 主干 66.28 GB,文本编码器另要 66.7 GB,两样加起来 133 GB。我这台机器运行内存 64 GB。
物理上装不下。所以这篇只回答三件事:这一档量化能出什么水平的图,哪几项会翻车,我为它花的 API 钱值不值。
先报家底
显卡 RTX 4070 Ti SUPER,16GB。内存 64 GB,系统里报 61.7 GiB。ComfyUI 0.45.2,torch 2.13.0+cu130。
模型用的是 Comfy-Org 重打包的量化版:主干 pruned_int8_convrot 20.98 GB,编码器 qwen3vl_32b 的 int8 版 27.14 GB,VAE 1.17 GB。仓库里的原始 bf16 和我这台机器没缘分。
27.14 GB 的编码器塞进 16G 显存,照样塞不下。
真正干活的是内存,显卡只负责采样那一段。ComfyUI 把放不下的权重留在内存里,当前要算哪个 block 就搬哪个上来,算完让位。这条机制后面要反复用到。
五个改动,每个都有具体原因。
主干上 int8,没得选,bf16 进不来。
编码器 int8 为主,另存一份 nvfp4(15.69 GB)做回退,省 11.5 GB。跑长提示词时 int8 编码器容易踩到贴边,回退档能救回来。
分辨率从官方模板默认的 4MP 抬到 16MP。模板 JSON 里写得很直白:刻意低于原生,免低显存机器 OOM。我这台既然靠内存兜底,就往上抬。
CUDA 用 cu130。社区有记录说 cu128 下 int8 内核会静默回退,慢约三倍。这条我没自己复现,照着配的。
不加 --lowvram。加了会把权重更早踢回内存,编码器更慢。
(顺带一句,跑起来风扇声不大。瓶颈不在算力。)
还有个容易被忽略的限制:这模型蒸馏到 6 步采样,不用 CFG,官方 API 也不接受负面提示词,传了直接返 400。ComfyUI 工作流里那个 negative 槽接的是零张量,等于没有。所以“负面词堆一屏”那套玩法在这里用不上。
显存没涨,涨的是时间
五张图,同一台机器、同一个脚本、同一套权重:
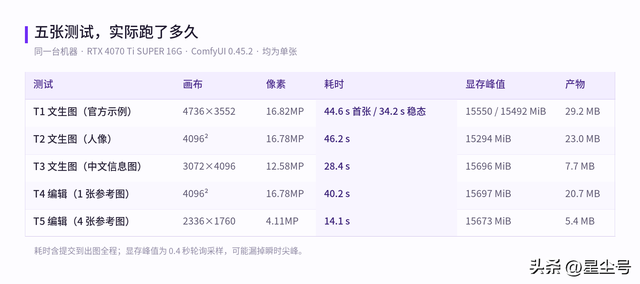
全部本机生成,RTX 4070 Ti SUPER 16G,内存 64 GB。
看峰值那一列。4.11MP 的编辑是 15673 MiB,16.78MP 的文生图是 15294 MiB。分辨率翻四倍,峰值差 379 MiB,而且是大的那张更低。
显存被钳在一个固定水位,多出来的活全压到内存带宽和 PCIe 上。所以代价不体现在显存,体现在秒表。
46.2 秒那张 4096² 含着首张的权重加载。文生图那张(T1)同样是 16MP 级,换 seed 后的稳态是 34.2 秒。同一台机器跑 4MP 的编辑只要 14.1 秒。
像素涨四倍,时间涨两点四倍。没有线性,因为文本编码和 VAE 解码这些固定开销在小图上占比更大。
这个换算对干活的人有用:出 16MP 一张的时间,够你出两张多 4MP 试构图。
有个 429 秒的故障
上面那张表我故意没写平均耗时。因为这台机器会抽风。
同一台机器、同一个脚本、同一个 2000×2000 画布,正常情况 12.98 秒,抽风的时候 429.5 秒。差了三十三倍。
第一次遇到,我以为参数写错了。第二次我盯了日志。
慢的那一次,文本编码器从 staged 到实际开始,中间空了 418 秒。采样阶段只占十几秒。
我又试了一次:把那段 599 字符的提示词拆成 290 和 309 两半,分别跑,16.1 秒和 14.1 秒。
跟提示词长度没关系。跟那一次显存的水位有关系。慢的那次峰值 15839 MiB,比快的几次高 160 到 290 MiB,而 16376 MiB 就是这台卡的全部家当。
多占两百兆,编码器权重就开始反复换页。
这是我的推断。profiler 没开,日志粒度也不够细,我没做更深的定位。但这条推断能解释我遇到的每一次抽风,都发生在这台机器显存贴边的时候。
实用结论只有一条:开跑前先 POST /free 把模型卸掉再重新载。我实测过一次,显存从 12663 MiB 降到 2994 MiB,可用内存从 17.8 GiB 回到 45.3 GiB。做完这一步,T2 到 T5 这四张连着跑,最快 14.1 秒,最慢 46.2 秒,没再抽风。
还有一个坑。同样的 prompt、同样的 seed 再跑一次,2 秒就出图。这不是它变快了,是 ComfyUI 认出这次的计算和上一次完全一样,把上次那张图直接复制过来,一步都没算。所以测稳态耗时必须换 seed,否则量到的是缓存速度。
官方放的图,没法严格对照
官方放出九张分类拼图,外加一张十五图拼成的主视觉。全部没有 prompt,没有尺寸,没有 seed。
唯一给全参数的是 examples/request.t2i.json:1546 字符的 prompt、4736×3552、seed 42。但官方只给了输入,没给这张的输出图。
所以能做的对照只剩两级。一级是同 prompt 同尺寸同 seed 复现,验的是指令遵循率。另一级是照同类题材自己写 prompt,验的是观感差距。
量化损失这件事,本篇给不出数字。要证它,得拿同一个 prompt 走一次官方 API 出图对比,那要花钱。我只能说本地是 int8、官方演示大概率是原版 bf16,两者有差距,但我不知道差多少。
这句话得先摆在这儿。后面所有“好看”“不行”的判断,都是拿我这台机器跟官方放出的成片比观感,不是跟官方模型比性能。
T1 文生图测试:内容都对
T1 用的是官方 request.t2i.json 原文,一个参数没改。
冷启动 44.6 秒,换 seed 稳态 34.2 秒。
那句 prompt 一千五百多字符,把桌面分成六个位置:中央的编织餐垫和酸面包,左上的铜碗蔬菜,右上的奶酪板,左下的番茄、核桃、橄榄,右下的红酒杯和黄铜烛台,还有一块压在中前、放着苹果片和布里的小砧板。
六块全在,位置也基本照描述排。
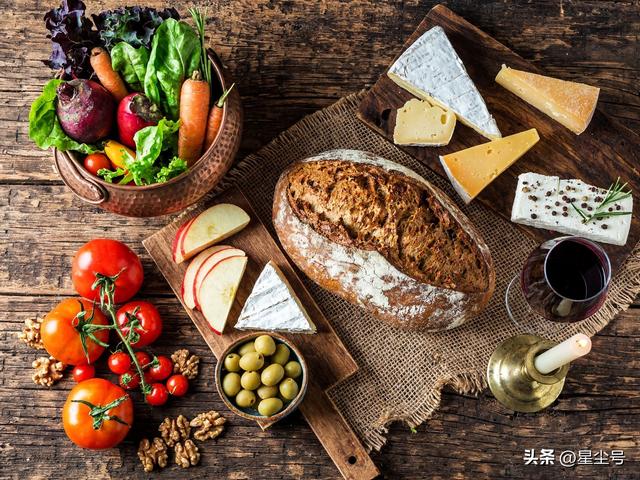
prompt 与尺寸照官方 request.t2i.json 原文;本机 RTX 4070 Ti SUPER 16G,4736×3552,稳态 34.2 秒,seed 43。
两处不对。面包裂口露出来的纤维,走向像用刀雕的,不像自然撕裂。布里奶酪的表面反光偏塑料,缺软质奶酪那层白皮该有的干爽感。
这两处得放大到 100% 才看得出来。缩到手机屏幕的尺寸,看不出来。
美食这一项我另跑了一张,同题材:五只煎饺、冰花脆皮、深色釉盘、红油碟、木筷。
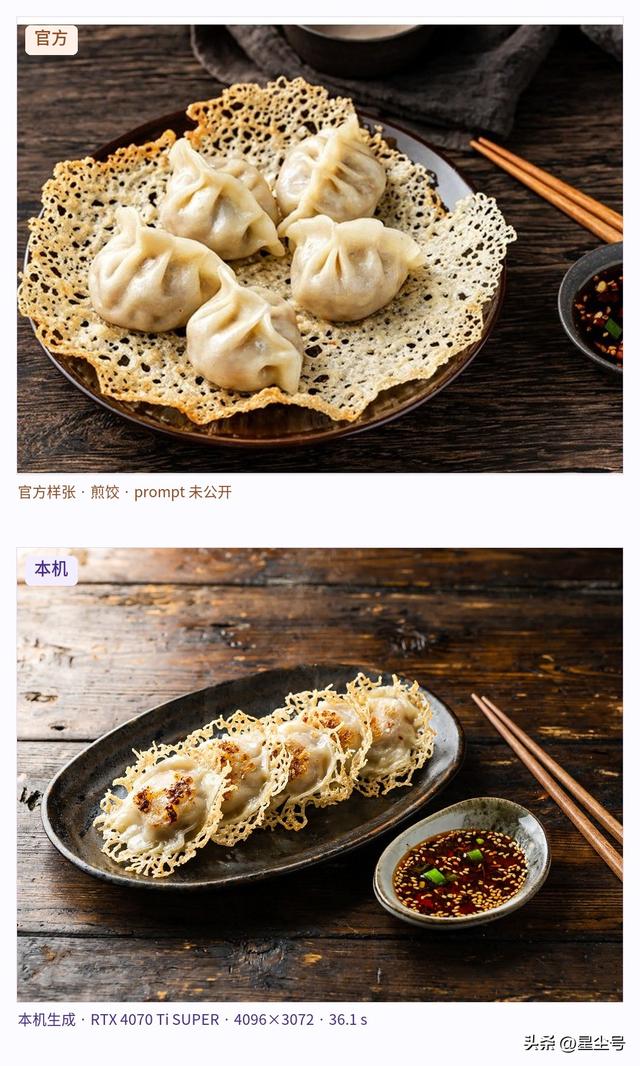
4096×3072,36.1 秒(含首张权重加载),seed 42。
差别很具体。官方的饺子皮薄,边缘能透出光;冰花是半透明的琥珀色,油光从脆皮下透上来。我这台的皮更厚更哑,冰花偏白,还断成几片,看着比官方那张“干”一点。
反过来,本机这张的配菜更细。红油碟里的芝麻、辣椒碎、葱花粒粒分明,油面的反光是真的;木桌的纹理和磕碰也在。官方的蘸料碟反而糊成一块暗红。
所以不是一边全面压另一边。光源、小物件、材质它都接得住,输的是那种“刚出锅”的通透感。
这个差距里有多少是 int8 的账,有多少是提示词不同的账,我分不开。
T2 文生图人像测试:脸能打,手也没翻车
T2 是英文长描述,4096²,46.2 秒。
出来那张,我第一眼是愣了一下的。
单侧窗光从左进来,脸转四分之三,脸颊落到阴影里,暗部还留着细节。深胡桃木的背景压到接近全黑,右半边几乎没有信息。
100% 放大看皮肤:鼻梁和颧骨上有成片的毛孔,不是噪点,而是有朝向的毛孔;颧骨边缘有细绒毛,被窗光照亮;上眼睑压出的阴影落在眼球上;眼球里有一块长方形的窗格反光。
这套细节放到手机上看,能骗过去。
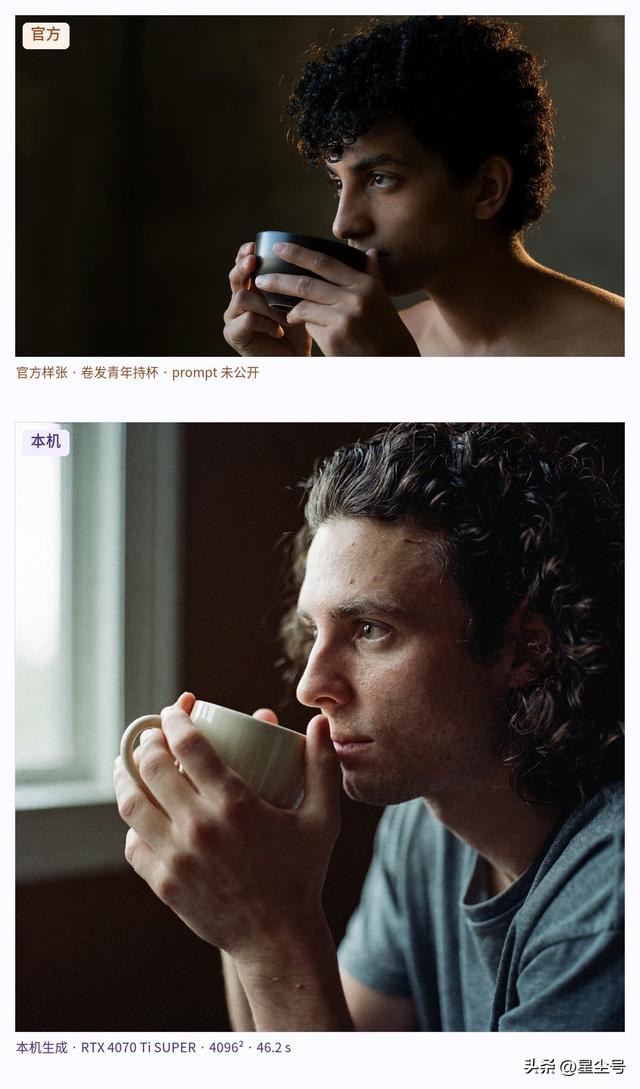
RTX 4070 Ti SUPER 16G,4096²,46.2 秒,seed 42。
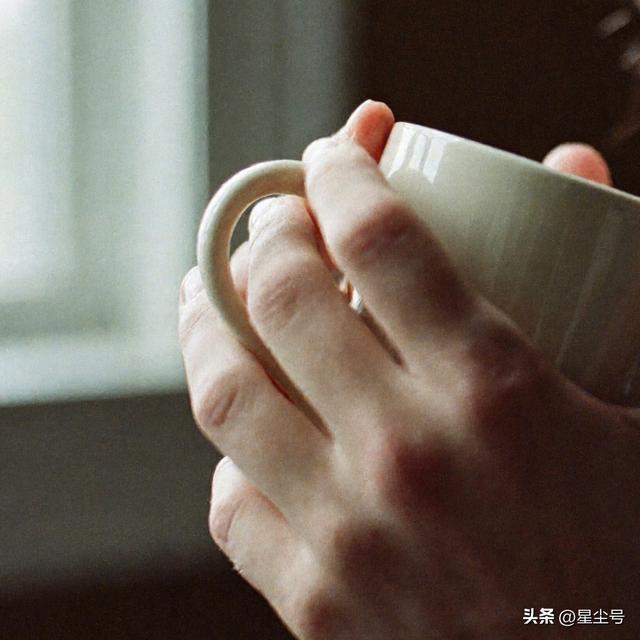
RTX 4070 Ti SUPER 16G,4096²,46.2 秒,seed 42。四指绕杯、拇指在杯后,没有多指、断指、粘连。
所以人像这一项,单人、半身、带手,都可以试。硬挑的话只剩质感上的差别,手背皮肤比真人更匀,指节的褶皱浅一点,没有结构问题。
(只有一张,不能证明它稳定。这一节说的都是这一张。)
T3 文生图中文信息图测试:一个错字都没有
T3 我没用官方那道题,另写了一道结构相同的:四人选三人,五条条件。
3072×4096,28.4 秒。
出来以后我逐字抄了一遍。
五条条件全对,一条没漏。“甲乙丙丁”四个字形全部正确,没有“甲”写成“由”,也没有“己”“已”混。
入选区写“甲、乙、丙”,未入选区写“丁”。
推导区三段:“假设甲不入选,则乙丙丁三人入选,与条件三冲突;所以甲必须入选,由条件二得乙入选;由条件四得丁不能入选,最后一人是丙。”
这道题是我自己设计的,唯一解就是甲乙丙。它推对了。
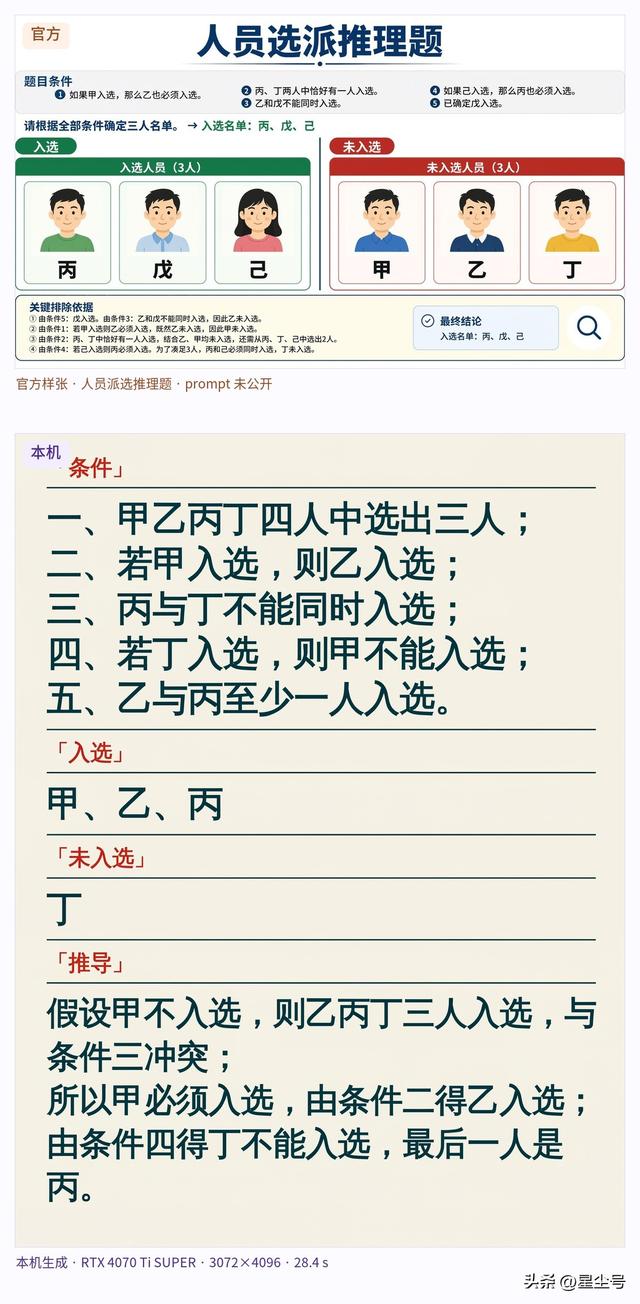
RTX 4070 Ti SUPER 16G,3072×4096,28.4 秒,seed 42。
中文长文本一直是画图模型的死穴,尤其“甲乙丙丁”这种形近字。官方那张推理图,我原本以为是挑最好的一张放出来。这台 int8 的机器一次过,我是真没想到。
(只有一张,不能证明稳定。但至少能证明这档量化没把字形写坏。)
T4 编辑测试:它会替你重拍
T4 用的是官方那对播客主持人的图,1024² 输入。指令三件事:去掉左边男士的头戴耳机、把压塌的头发补回来、两人倾身越过 MONEY TALKS 桌牌碰拳。
4096²,40.2 秒。
三件事全做到了。耳机没了,头顶补成一头卷,两人真的倾身,拳头正对中间。
细节也保住了不少:桌牌上 MONEY TALKS 一个字母没丢,两只杯子上的 INVEST IN YOURSELF 和 PLAN BUILD WEALTH 都对,右上角 EP. 47 在,墙上三块挂画也在。
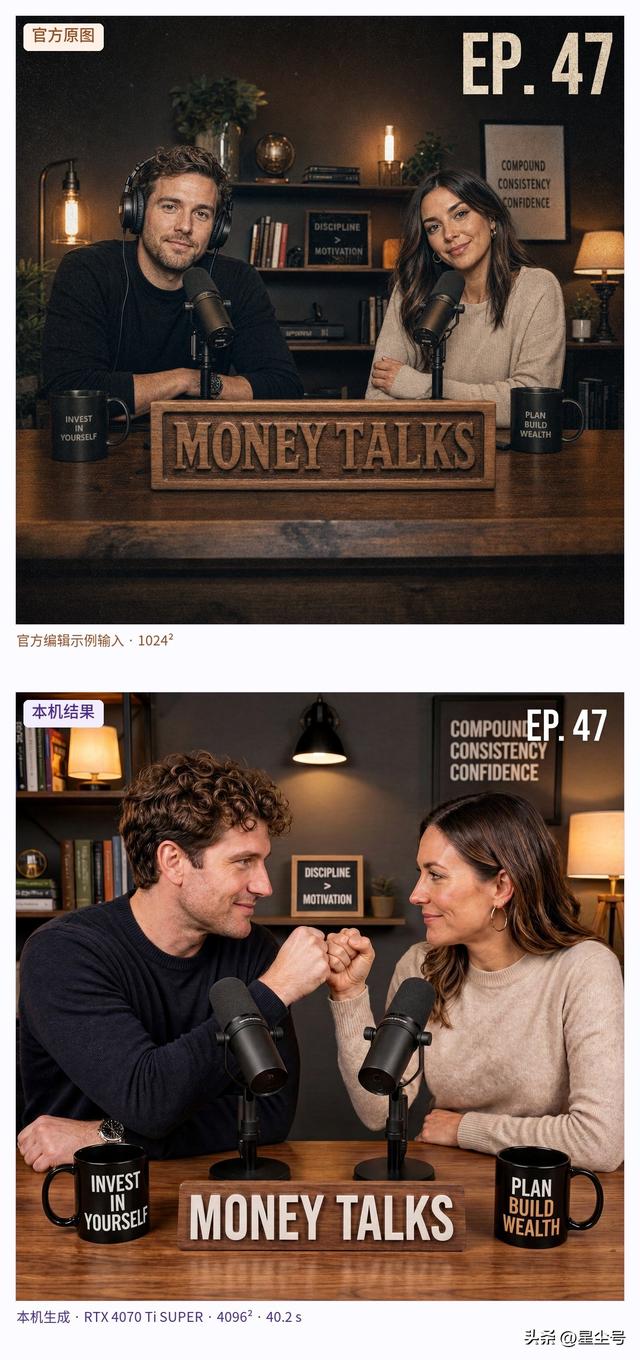
RTX 4070 Ti SUPER 16G,4096²,40.2 秒,seed 42。
它干的活是重拍。原图只当参考,构图、机位、道具位置全都重新安排过。
桌牌被放大,挪到画面正下方,原来它在两人中间偏下的位置。两只杯子从桌上飞到了前景两个角,尺寸也变大了。麦克风的位置和角度全换过。整体的画风较原图少了一点噪点感,原图的观感更接近真实相机拍摄。
还有一处硬伤。原图里 EP. 47 在右上角的空墙上,海报在它下面,两者不挨着;重拍之后海报被往上挪了一截,第一行 COMPOUND 正撞进 EP. 47 底下,最后一个 D 只剩半个。
所以编辑这个功能的真实定位:你给一张图加一段话,它给你一个照这个意思重拍的版本。要它保住构图,得在 prompt 里一条一条钉死,钉漏一条它就开始自由发挥。
T5 多图参考测试:它顺手把房间也改了
T5 官方那张是空房间加九件家具。我压到四件:沙发、圆桌、单椅、边柜,4MP 画布。
参考图是我先跑出来的五张干净素材。空房间 12.1 秒,四件家具 8 到 10 秒一张。没用官方拼图里那些 300px 的小图,怕低分辨率干扰结论。
14.1 秒出结果。
四件家具全用上了,没凭空多出第五件,投影方向也统一,光从右边的窗进来,影子都往左倒。
房间被重建了。
原图的窗是黑色细框,一整条通到天花板;出来变成白色粗框,还切成上下两格。原图后墙是暖白色的实墙,出来凭空多了一个门洞。地板铺装方向转了差不多九十度。天花高度和相机视角也换了。
家具本身也走样。圆桌在参考图里是三条圆柱腿,出来是两条腿加一片竖着的鳍板。单椅的右扶手悬在半空,没接到后立柱上。参考图里那个橄榄绿坐垫,丢了。
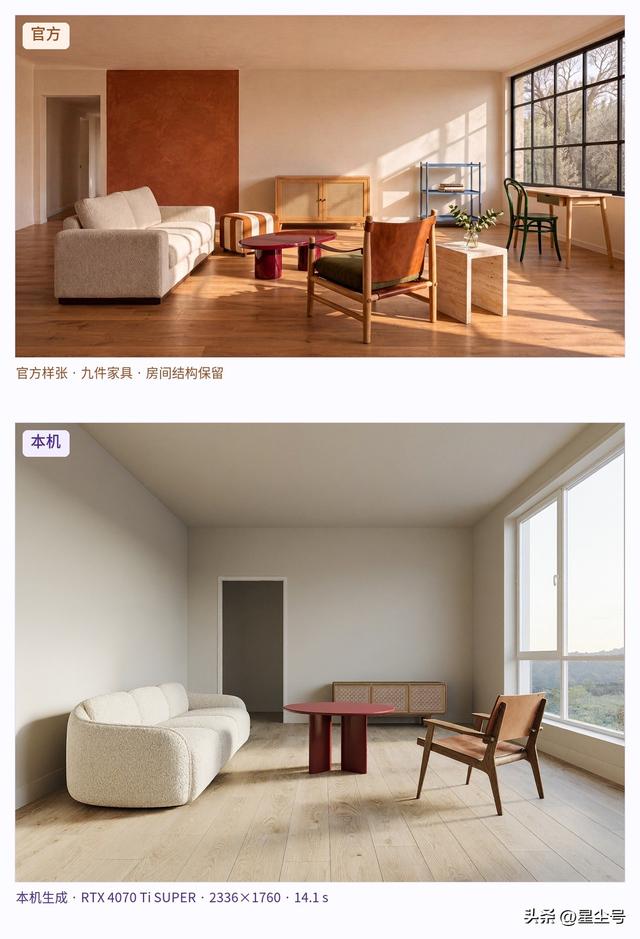
RTX 4070 Ti SUPER 16G,2336×1760,14.1 秒,seed 42。
多图参考给的是“照着你给的这几件东西,重新设计一个房间”。你给的那个房间,它只当气氛参考。
PE 提示词扩展器
先说它是干什么的。
H3-Image 在官方设定里,要的是一段详细的英文画面描述:主体、光线、材质、构图,全都写出来。你在官方 API 里敲一句中文,云端会先用一道专门的工序把它翻成这种描述,再交给画图模型。PE 就是这道工序的本地版,全称 Prompt Expander,中文叫提示词扩写器。
所以开和关的差别不在画质,在谁替你写这段描述。开着:机器替你扩,你省事,但画面内容它说了算,还要多等一道工序。关掉:你自己写,写多细就多细,写一句也行,只是模型只能拿这一句去猜。
ComfyUI 这套模板里,它默认是关的。我为了弄清它有没有用,手动打开过。
官方那个扩写器是 MiniMax-H3-Image-PE,底座 27B 的语言模型,NVFP4 量化,17.9 GB 权重,跑起来要占约 19 GB 显存。我这台 16G 卡装不下。我实际用的是模板里配的 qwen3.5_9b_w4a8_gptq,9B,7.34 GB。两个不是同一个模型。
打开以后出的第一张图,是一张游戏角色设计板,标签上还有中文乱码。当时我下的结论是“PE 会重写意图,关掉”。
现象没错,原因错了。
毛病有两个。模型小了一号,27B 换成 9B。模板又只给了它模型,没给官方那两份说明:一份 326 字符,规定它扮演什么角色;一份 15821 字符,规定它具体干什么活。
它不知道自己该干什么,于是回了这么一段:
“This is a beautiful concept for an image. Since I am a text-based AI, I cannot generate images directly, but I can provide you with optimized prompt variations...”
后面跟着 Midjourney、DALL·E、SDXL 三个平台的写法建议。它以为自己在当提示词顾问。
模板要的是另一件事:从它的话里抠出一段扩写好的画面描述,直接拿去画图。抠不到,就把这一整段独白原样塞进了画图模型。
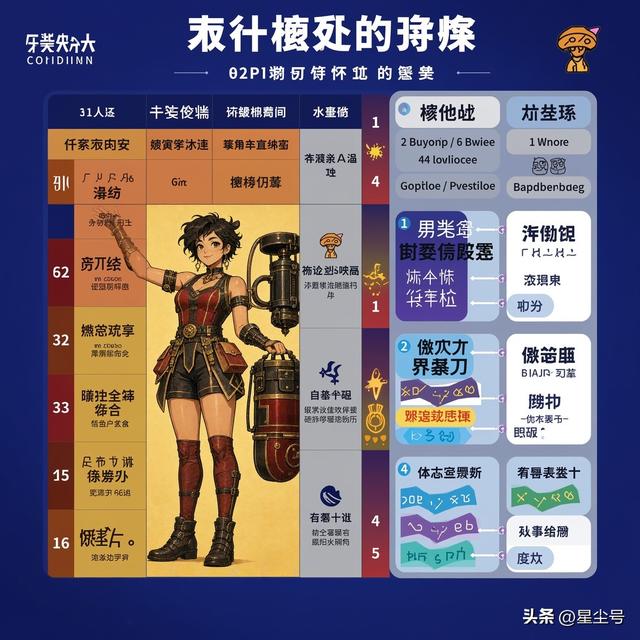
提示词只有一句“潜水头盔,湿玄武岩上,黎明,盐霜与氧化”,本机生成,4000²,58.2 秒(含扩写)。
设定板不全是 bug。那份任务说明交代的第一件事,是给输入分类:一类是照片和场景;另一类是信息图、海报、角色卡、产品设计板、UI、图表、包装。判成后一类,要求就一句,build a finished information architecture, not just a scene。要交一张完整版面,不是一张场景图。
所以哪怕说明接对了,你给一句“潜水头盔”,它也可能按产品设计板处理,交回一张带标注的板子。它照规程办事,只是这规程跟“我要一张图”的期待不一样。
把官方那两段说明手动喂进去,同一个 9B 立刻按格式交活:一段扩写好的英文描述,加一个建议画幅。它自己补了左向来光、玻璃面罩映天光、皮革带松垂、岩石上的水珠、背景薄雾。原句里我一句都没写。代价 232.9 秒,一张图。
中文也试了。输入“一个穿红色雨衣的女孩站在雨夜的便利店门口,霓虹灯牌的光反在积水上”,26.3 秒交活,扩写是英文,画幅自己判了 4:5(出图我没照它,锁的 2000²)。
关掉 PE,把这句中文直接给画图模型:20.4 秒,雨夜、红雨衣、便利店、地上的反光全在,还自己添了把伞。短句它不是不认,是信息不够,只能照最常见的样子补。
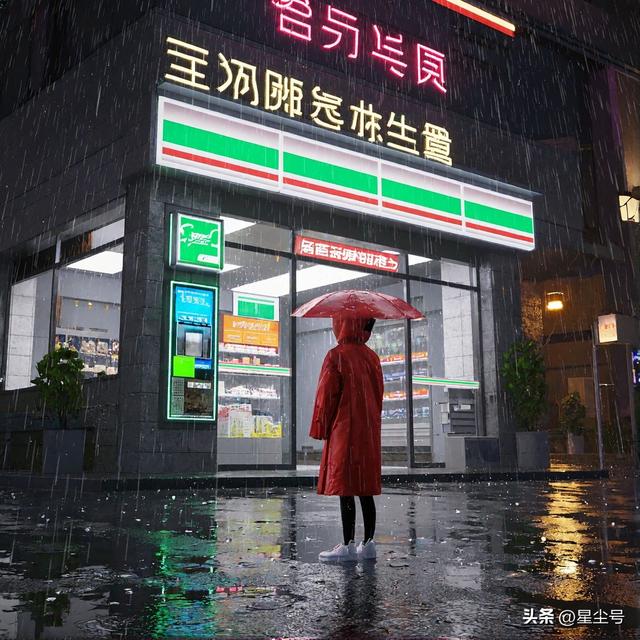
本机生成,2000²,20.4 秒。招牌上那串字是它编的,看着像汉字,念不出意思。这句里我没说要写什么字;T3 那道中文信息图把内容写死了,反倒一个字不差。
三张同题对照,4MP,seed 42:
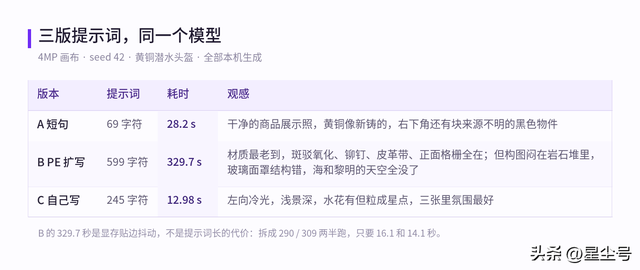
全部本机生成,RTX 4070 Ti SUPER 16G,4MP 画布,seed 42。
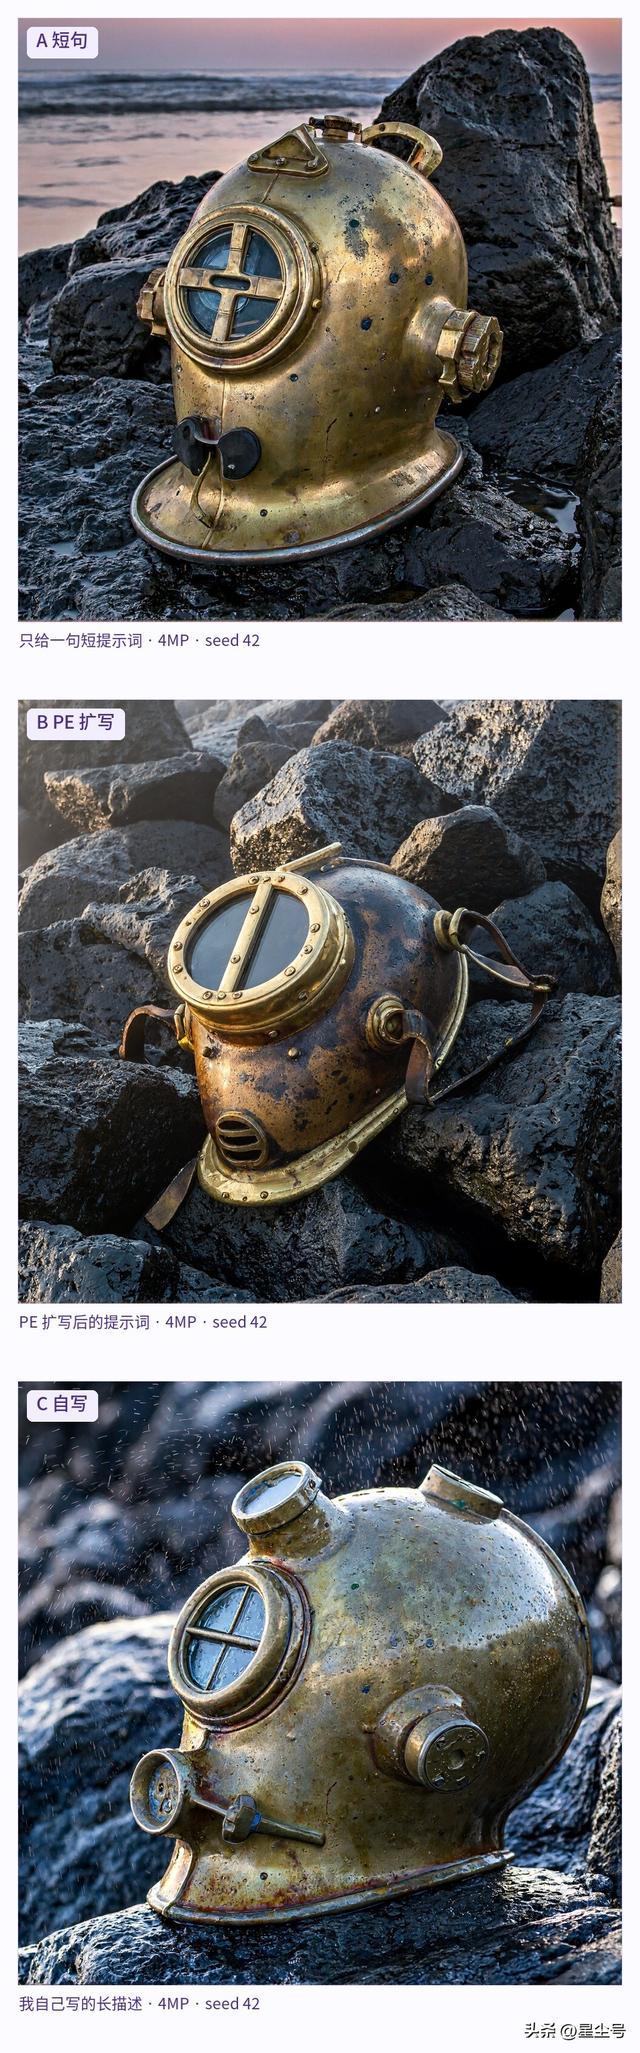
RTX 4070 Ti SUPER 16G,4MP 画布,seed 42。
PE 补的是细节密度,不管构图和审美。三张里 B 的材质最老到,斑驳氧化、铆钉、皮革带、正面格栅全在,可它把构图闷在岩石堆里,玻璃面罩结构也错了,海和黎明的天空直接没了。它替你把画面定死,你原来想要的那半张,可能留不住。
默认关是对的。但理由不是“PE 会重写意图”,是这条路压根没接对,接对了也不划算。自己写一段,12.98 秒,三张里氛围最好。
只有一种情况值得开:你手里只有一句短话,懒得自己扩,也不急。这种输入它二十几秒就能扩完,等得起。
这笔账算下来
官方 API 4K 单张 $0.0688,11 月 17 号 16:00 UTC 前五折,$0.0344。编辑带一张参考图 4K 是 $0.0731,折后 $0.0366。
按全价和 7.2 的汇率估,五毛钱一张。
这台机器整机按万元级算。一万块,要出两万张才追平 API 的钱。一天十张,得跑五年半。按五折算,就是十一二年。
省钱不是本地这套东西的卖点。
它换来的第一件事是图不出门。做产品、做医疗、手上有未公开素材的人,这条是硬需求。第二件是随便试:本地试二十版构图,一分钱不花,试错成本从“每次五毛”变成“每次三十秒”。
电费可以忽略。34 秒满载大概 0.003 度,按五毛五一度算不到两分钱。这是估算,我没接电表。
许可得单独说一句,我读了原文。协议叫 MiniMax-H3-Image Community License Agreement,权利方 Nanonoble Pte. Ltd.,管辖法是中国香港法律。三条要注意:年化收入超过一百万美元,或者对外提供 Hosted Service,要事先书面授权;商业产品或服务必须在界面显著展示 “MiniMax-H3-Image”;欧盟、英国、韩国、美国是排除地域,在这些地方不能使用、复制、修改、分发,连输出都不行。
(这条对国内创作者影响不大。但你要是给海外客户做图,签合同前先看清楚。)
写在最后
人像、信息图、编辑、多图这四张跑完,128.9 秒;加上文生图那张的 44.6 秒,一共 173.5 秒,不到三分钟。
跑下来整体是满意的:写实人像的脸、中文长文本这两项,它给的是能直接用的东西。
不行的两处:多物体的结构保真,编辑时保住原构图。
所以现在该不该装,我这么分。
手上是 16G 以上的卡、内存 64G 起、能接受一张图等半分钟到一分钟、主要做单人像或者中文信息图,装。模型换 int8 量化版,模板改两处:分辨率抬到 16MP、CUDA 换 cu130;PE 默认就是关的,不用动。另外别加 --lowvram。就这些。
作者:星尘号 | 发布于今日头条,2026-11-11 | 原文链接:https://www.toutiao.com/article/7706883287427318281/